晚上 9 点 40 分,我正准备睡觉,手机上的监控先响了:博客打开要转圈 10 多秒,平时不到 1 秒。SSH 连上去,敲一个 ls 都要等两三秒才回显,top 一打开,CPU 使用率 99%,load average 8 点多——2 核的机器,负载 8 意味着排队等 CPU 的进程堆了 4 倍。第一反应是重启服务器,但重启只是把问题藏起来 10 分钟:那个进程还会再起来,CPU 还会再飙上去。这篇就讲 CPU 飙高时,怎么在 5 分钟内定位元凶,而不是靠重启碰运气。
先分清:CPU 高和负载高不是一回事
动手之前先看懂 top 顶行的两个数字,很多人就是在这里看错了方向。第一是 %Cpu(s) 这一行:us 是用户进程占的,sy 是内核占的,wa 是等磁盘 IO 占的,id 是空闲。如果 wa 很高,瓶颈其实在磁盘,不在 CPU。第二是 load average,1 分钟、5 分钟、15 分钟三个数,它是平均有多少进程在排队等 CPU。2 核机器 load 长期超过 2 才算真忙,1 核的 VPS load 到 1 就已经满了。还有一个 VPS 上容易被忽略的 st(steal):宿主机把你的 CPU 时间抢走了,st 长期超过 10%,调程序基本没用,换节点比调程序管用。
记住这个判断顺序:先看 wa 和 st 排除磁盘和宿主机,再看 us 还是 sy 占大头——us 高是应用的问题,sy 高要怀疑内核、驱动或者大量的网络中断。分清这一步,后面才不会走弯路。
还有一个新手常问的问题:top 里单个进程的 %CPU 为什么能超过 100%?因为这是按单核算的,2 核机器上一个多线程进程占满两个核就会显示 200%。所以看进程占用要结合核数:4 核机器上 380% 才算吃满,2 核机器上 190% 就已经满了。反过来,load average 是全机排队数,不用换算,直接对照核数就行。
五步定位法:从现象到元凶
第 1 步:看全局,确认是不是真忙。先跑 uptime 看三个负载数,再进 top 看 %Cpu(s) 那一行。关键是看 5 分钟和 15 分钟的负载是不是也在涨:如果 1 分钟 8 点多、15 分钟才 0.5,说明只是刚起来的毛刺,等一分钟可能自己下去;三个数都在往上走,才是真的出事了。
第 2 步:按 CPU 排序,揪出第一名。top 里按 Shift+P,占用最高的进程会排到最上面;或者直接用 ps 一次列出来。重点看 %CPU 这一列:多核机器上单个进程超过 100% 是正常的,意思是它占满了一个核还多,别被这个数字吓到。
图:top 里的 CPU 占用条——一眼就能看出是哪一个进程把 CPU 吃满了
第 3 步:查这个进程是谁、在干什么。拿到 PID 之后别急着杀,先弄清它的身份:读 /proc/PID/cmdline 看完整命令行,systemctl status 看它属于哪个服务,lsof -p PID 看它打开了哪些文件和网络连接。这一步决定了后面是重启服务、改配置还是封 IP,杀错进程可能把数据库一起带走。
第 4 步:查它为什么突然变忙。进程本身没毛病,毛病往往在触发它的东西上:先看定时任务,crontab -l 和 systemctl list-timers --all 能看到最近跑过什么;再看访问日志,统计最近 10 分钟请求最多的 IP 和 URL;怀疑死循环就用 strace 跟一下它在反复调用什么。
第 5 步:处置,先限流后重启,-9 最后用。能限流的先限流:爬虫打爆就临时封 IP,能停服务的先 systemctl stop 再看。必须杀进程时先记下 PID 和命令行,留作复盘证据;服务类进程优先用 systemctl restart,让它自己清理状态;kill -9 是最后手段,数据库、PHP-FPM 这类带状态的进程被 -9 杀掉,可能丢数据或者留下锁文件。
⚠️ 提醒一句:动手之前先把 top 和 ps 的输出截个图或者重定向存下来。重启之后现场就没了,复盘的时候全靠这几行输出。
完整案例:一台博客 VPS 的 CPU 是怎么被爬虫打满的
背景:一台 2 核 4GB 的 VPS,跑一个 Typecho 博客,日均 800 次访问,平时 load 在 0.3 到 0.6 之间,CPU 占用不到 10%,已经稳定跑了 3 个月。
现象:某天 21:40 起,网站打开要 10 秒以上,SSH 敲命令也要等两三秒。top 显示 CPU 99%,load average 8.31、7.92、6.45,三个数全在高位,说明不是毛刺,是持续超载。
排查:top 按 Shift+P 排序,第一名是 php-fpm,单个进程占 187% CPU,往下数 12 个 php-fpm 子进程全在忙。wa 只有 0.2,磁盘没问题;st 是 0,宿主机没抢时间。顺手查了 crontab 和定时器,当晚没有备份任务在跑,排除了定时任务的可能;内存用了 61%,磁盘 IO 也正常,进一步确认就是 CPU 被请求打满了。查访问日志:最近 10 分钟里同一个 IP 发起了 2400 多次请求,全是站内搜索页,还带着随机关键词;再看插件:站内搜索插件对每次请求都要全表扫描,请求一多就把 CPU 吃满了。
处置:先在 nginx 里临时封掉这个 IP 段,请求量立刻掉下来;然后关掉站内搜索插件,systemctl restart php8.2-fpm 让进程池重新初始化。整个过程没重启服务器,网站一直在线。
复查结果:处置后 2 分钟,load 回到 0.62,CPU 占用 7%,首页打开耗时 0.4 秒;当晚 22:30 再看,load 稳定在 0.5 左右。第二天把搜索换成静态页缓存,同样请求量下 CPU 不到 15%,问题彻底解决——根因是爬虫加低效插件,不是机器配置不够。
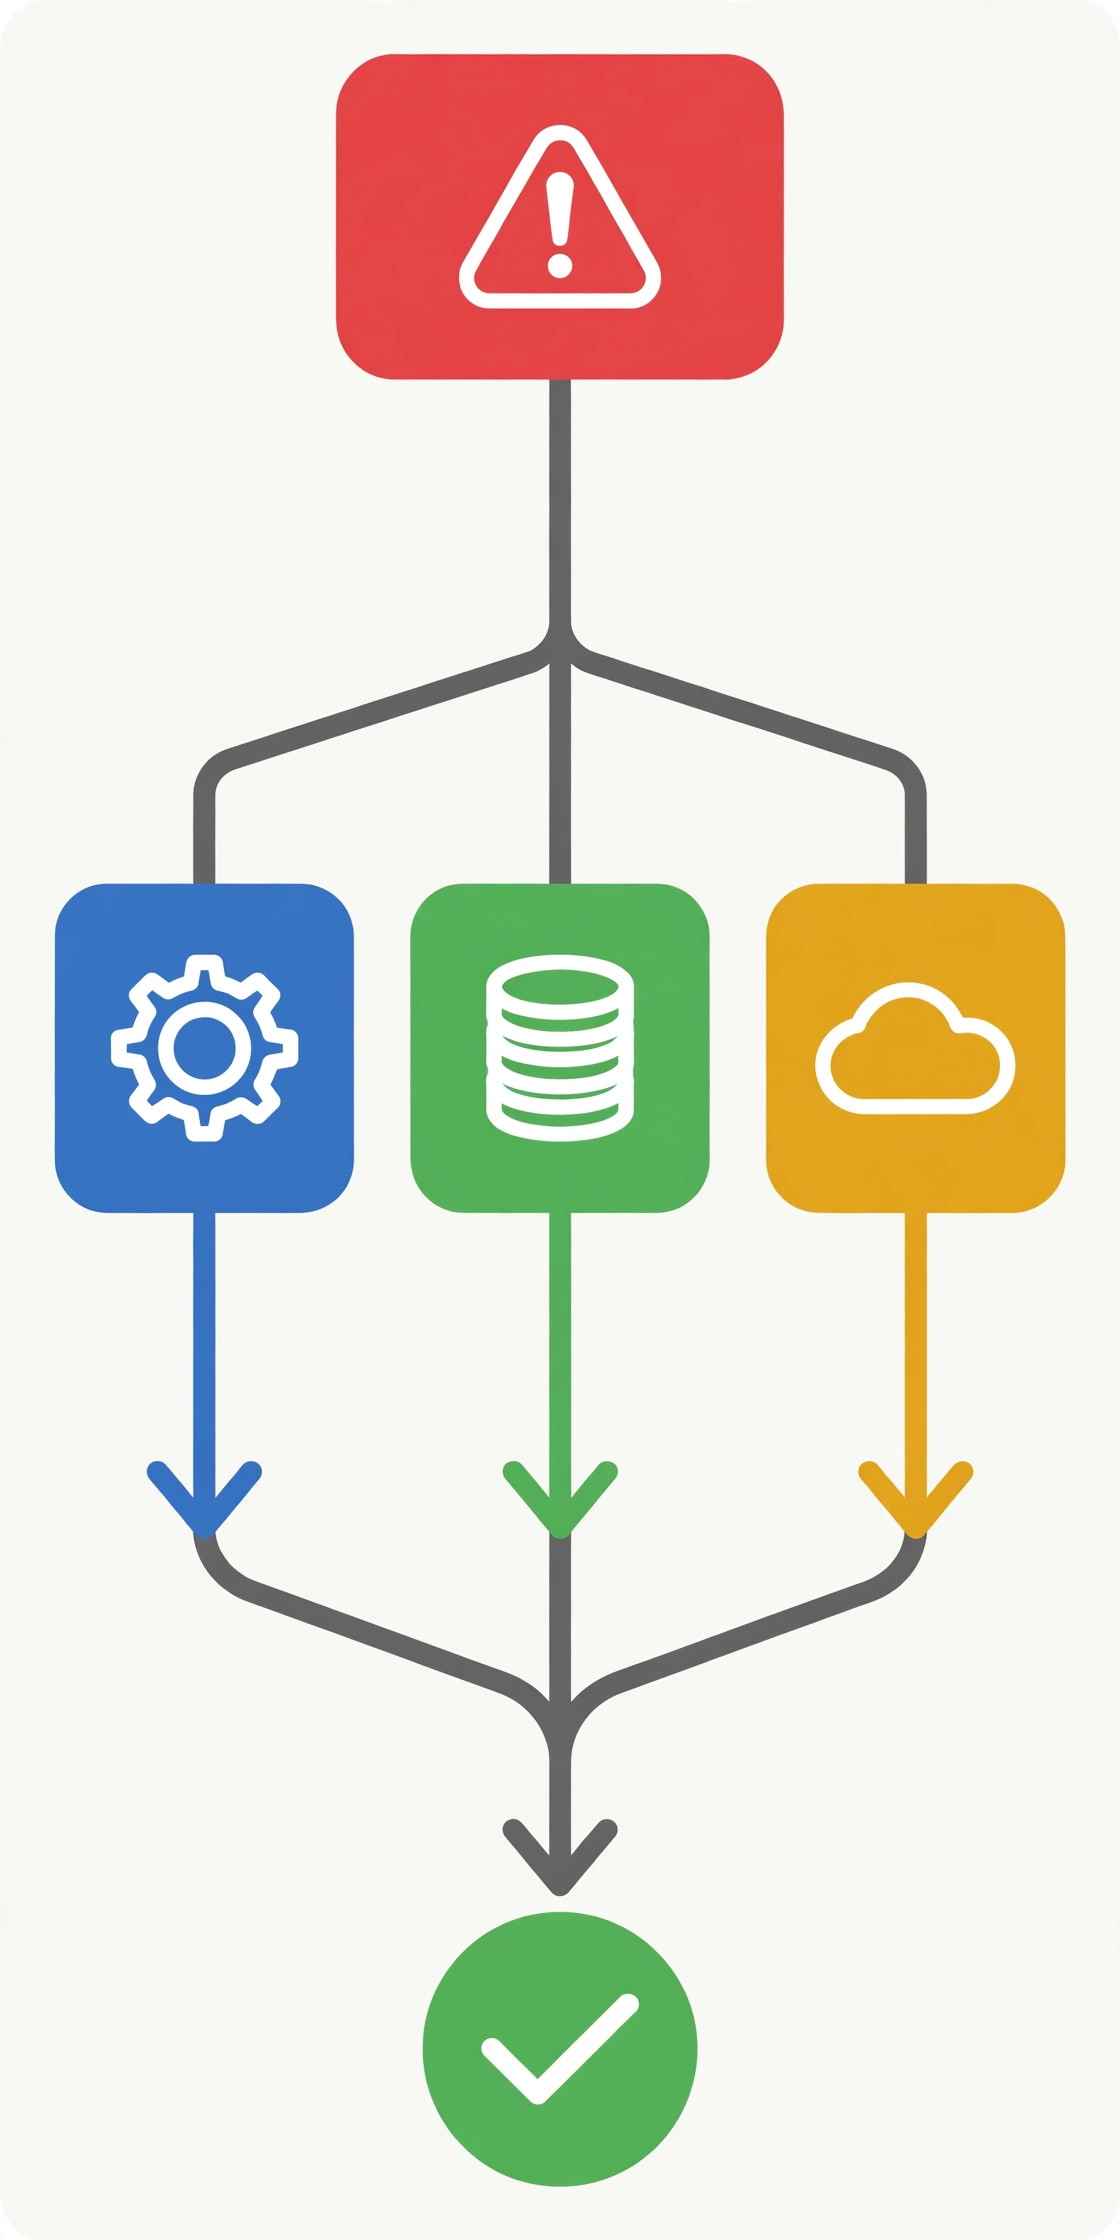
图:排查路线——从 top 看全局,到 ps 找进程,再到日志找触发源,最后处置并复查
三个最容易踩的坑
1. 一上来就重启服务器。重启能让 CPU 数字暂时好看,但触发问题的爬虫、定时任务、低效插件一个都没解决,10 分钟后照样飙上去;而且重启会清掉现场,复盘的时候连证据都没有,更糟的是还会打断正在跑的备份和队列任务,本来没坏的东西也被重启搞坏了。先 top、ps 留证据,再动手。
2. 看到 CPU 100% 就加配置。wa 高是磁盘慢,st 高是宿主机抢,加核对这两者都没用;sy 高可能是中断风暴,也不是加核能解决的。先分清 us、sy、wa、st 再决定要不要升级,升级之前先确认瓶颈真的在算力上。
3. kill -9 随手杀。数据库、PHP-FPM 这类带状态的进程被 -9 杀掉,可能丢数据、留下锁文件或者半写的文件,下次启动反而更慢。先 systemctl stop,不行再 kill,最后才用 -9,而且杀之前记下 PID 和命令行。
小结清单
① 先看 top 顶行:us、sy、wa、st 分清谁在忙,load 对照核数看排队程度;② top 按 Shift+P 排序,加 ps aux --sort=-%cpu 揪出元凶进程;③ /proc、systemctl、访问日志三件套,查清进程在干什么、谁在触发它;④ 处置先限流后重启,kill -9 是最后手段,动手前先留证据;⑤ 处置完复查 load 与首页耗时,确认回到基线才算完。